Bug informatique : du premier symptôme au correctif, sans perdre ses données
Un bug informatique est un défaut dans un programme qui provoque un comportement incorrect ou inattendu : calcul faux, bouton inactif, fichier mal enregistré ou application qui se ferme. Pour le résoudre, il faut distinguer le symptôme de sa cause, protéger les données, puis identifier les conditions du problème. Redémarrer peut dépanner ; cela ne prouve pas que le défaut est corrigé.
Reconnaître un bug sans confondre toutes les pannes
Un logiciel est censé respecter un comportement attendu, défini par ses spécifications et les besoins auxquels il répond. Un bug apparaît lorsqu’un défaut de conception ou de programmation l’en éloigne. Par exemple, une boutique qui facture deux fois les frais de livraison présente une anomalie, même si aucune page ne plante.
À l’inverse, une connexion interrompue ou un disque défectueux peuvent provoquer un dysfonctionnement sans qu’un bug logiciel en soit la cause. Le message affiché est un indice, pas un diagnostic. Une erreur de saisie peut également être normale ; c’est sa mauvaise gestion par le programme qui constitue éventuellement un bug.
| Terme | Ce qu’il désigne | Exemple |
|---|---|---|
| Erreur | Une action ou un raisonnement incorrect | Le développeur utilise une mauvaise formule. |
| Défaut ou bug | Une anomalie présente dans le logiciel | La formule incorrecte est intégrée au programme. |
| Régression | Un défaut introduit par une modification | Une mise à jour casse un export auparavant fonctionnel. |
| Crash | Un arrêt brutal du programme | L’application se ferme pendant l’export. |
| Incident | Une perturbation du service, quelle qu’en soit la cause | Le service devient inaccessible. |
Une fonctionnalité, elle, correspond à un comportement voulu. Mais qualifier une anomalie de « fonctionnement normal » ne suffit pas : il faut vérifier ce qui était prévu, documenté et compréhensible pour l’utilisateur.
Comprendre pourquoi le problème apparaît maintenant
Certains bugs existent longtemps sans se manifester. Ils attendent une combinaison particulière : un champ vide, un volume inhabituel de données, deux opérations simultanées ou une nouvelle version du système d’exploitation. Le dernier changement observé est donc une piste utile, mais pas une preuve de responsabilité.
Des erreurs humaines aux interactions techniques
Une condition oubliée, une exigence ambiguë ou une hypothèse devenue fausse peuvent introduire un défaut. La pression des délais et une communication insuffisante favorisent aussi les oublis. À cela s’ajoutent les interactions entre application, bibliothèques, pilotes et services externes : chaque composant peut fonctionner isolément, mais échouer dans une combinaison précise.
Un ralentissement peut ainsi venir d’une mauvaise gestion de la mémoire ou d’une requête trop coûteuse. Un blocage intermittent peut résulter d’un conflit entre tâches concurrentes. Ces problèmes sont difficiles à reproduire parce que leur déclenchement dépend de l’état du système au moment exact de l’exécution.
Des conséquences qui dépassent le simple inconfort
Un défaut d’affichage gêne la lecture ; une erreur de calcul peut fausser une facture ; un enregistrement incomplet peut corrompre des données. Certains bugs créent aussi une vulnérabilité exploitable, sans que tout bug soit pour autant une faille de sécurité. La priorité dépend donc des conséquences, du nombre de personnes touchées et de l’existence d’un contournement sûr.
Les exemples historiques illustrent ces différences. L’échec du premier vol d’Ariane 5 en 1996 rappelle les risques liés aux hypothèses logicielles réutilisées dans un nouvel environnement. Le bug de l’an 2000 concernait notamment les dates enregistrées sur deux chiffres. Les accidents du Therac-25 montrent, quant à eux, pourquoi un logiciel critique doit être entouré de protections indépendantes.
Face à un bug : protéger, observer, puis signaler
Pour un utilisateur, l’objectif immédiat n’est pas de modifier le code, mais d’éviter d’aggraver la situation. Si l’action concerne un paiement, une suppression ou un enregistrement important, ne la répétez pas aveuglément. Vérifiez d’abord si elle a déjà été exécutée malgré le message d’erreur.
- Protégez le travail récupérable. Enregistrez une copie distincte si possible, sans écraser la dernière version saine.
- Relevez les faits. Notez l’heure, le message exact, l’action effectuée et le résultat obtenu.
- Décrivez l’environnement. Précisez l’appareil, le système, la version de l’application ou le navigateur.
- Testez prudemment. Avec des données sans valeur, vérifiez si le problème revient dans les mêmes conditions.
- Contactez le support. Transmettez une description exploitable, en masquant les informations confidentielles.
Un signalement utile ressemble à ceci : « Dans l’application de facturation, l’export d’une facture contenant une remise ferme la fenêtre. L’export fonctionne sans remise. Le problème est apparu après la dernière mise à jour. » Cette description aide davantage qu’un simple « ça ne marche pas ».
Pensez aussi au principe du fusible : lorsqu’une opération risque de propager une erreur, mieux vaut interrompre temporairement cette opération que multiplier les dégâts. Suspendre un import qui altère les fiches clients protège le reste de la base. Cette mesure de confinement ne répare pas le programme, mais elle limite le périmètre de l’incident et préserve les éléments nécessaires au diagnostic.
Du diagnostic au correctif : le travail de débogage
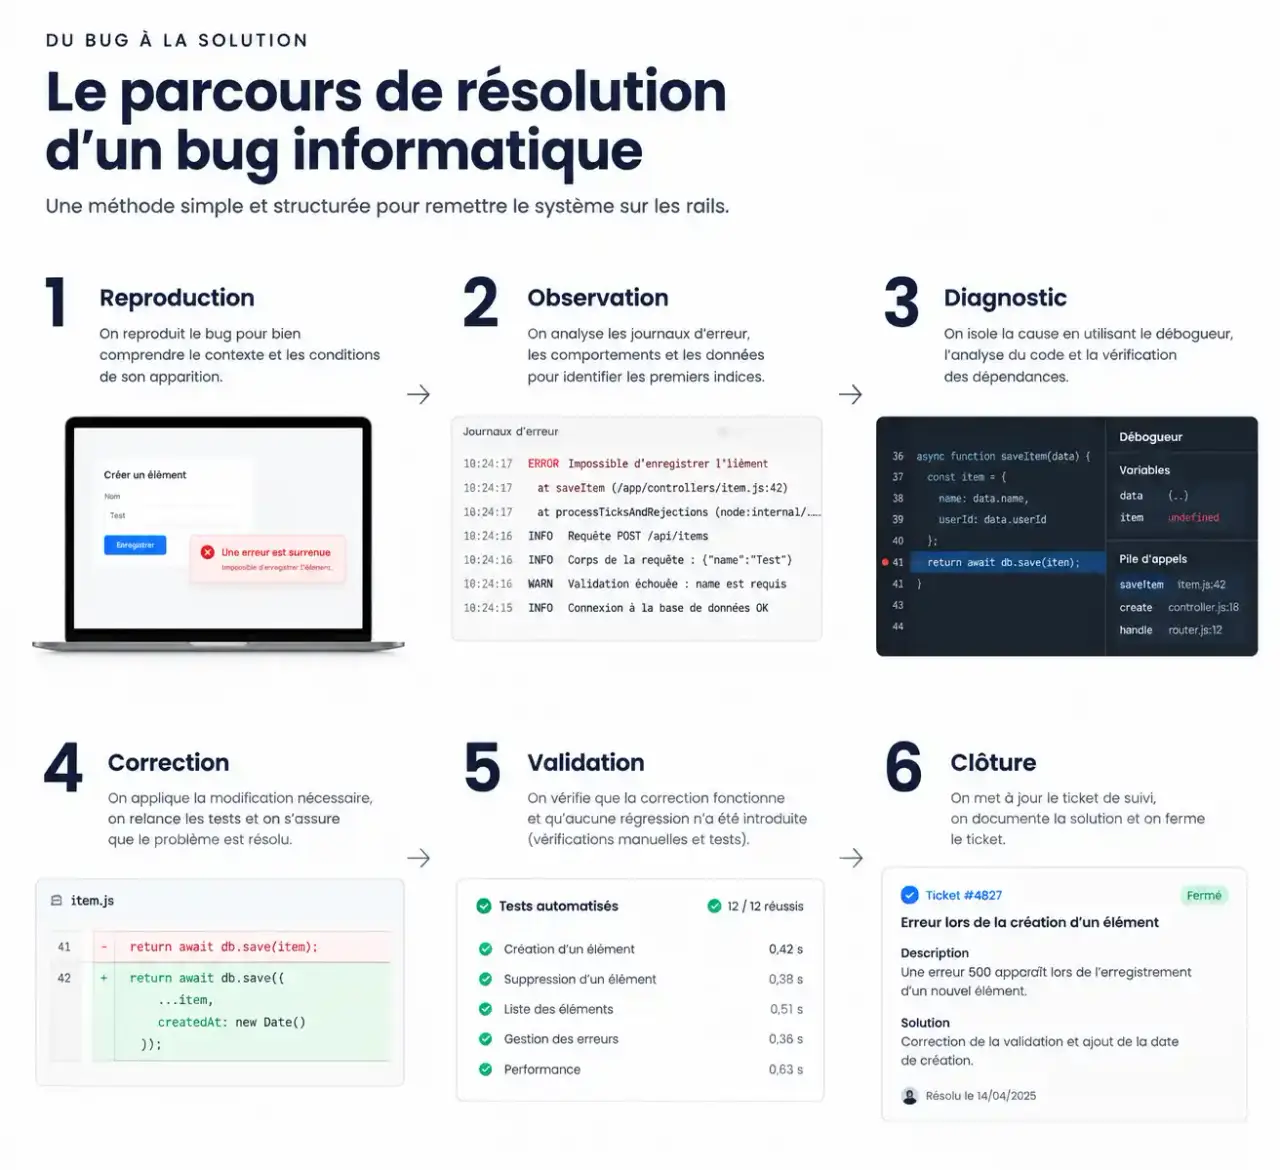
Le débogage consiste à rechercher la cause du comportement observé, puis à la corriger. Le développeur commence généralement par reproduire l’anomalie dans un environnement maîtrisé. Il réduit ensuite le scénario : quel fichier, quelle donnée ou quelle étape suffit à déclencher le défaut ?
Rapport officiel sur l’échec du vol 501 d’Ariane 5 | Analyse de référence de la commission d’enquête sur les causes et les enseignements de l’échec du premier vol d’Ariane 5 en 1996.
Observer l’exécution ou analyser les traces
Le débogage en ligne permet d’observer un programme pendant son exécution, avec un débogueur : points d’arrêt, inspection des variables et progression instruction par instruction. Cette méthode aide à repérer le moment où l’état réel s’écarte de l’état attendu.
Le débogage post-mortem intervient après l’échec. Il repose sur les journaux d’événements, les traces d’erreur et, lorsqu’il est disponible, un core dump, qui conserve un état de la mémoire du processus. Ces fichiers peuvent contenir des données sensibles : leur partage doit être encadré.
Valider avant de clôturer
Une fois la cause identifiée, un correctif modifie le code défaillant. L’équipe rejoue le scénario initial, puis vérifie les fonctions voisines pour éviter une régression. Le système de suivi des bugs conserve les étapes de reproduction, la priorité, la version corrigée et le résultat des vérifications. Un ticket doit pouvoir être rouvert si l’anomalie persiste.
Prévenir les récidives sans promettre le zéro bug
La prévention combine plusieurs contrôles, car aucun ne couvre tous les risques. Les tests unitaires vérifient des composants isolés ; les tests d’intégration examinent leurs échanges ; les tests de validation contrôlent les usages attendus. Les tests automatisés de non-régression permettent de rejouer régulièrement les scénarios déjà connus.
La revue de code apporte un regard extérieur sur les choix et les oublis possibles. L’analyse statique recherche certaines anomalies sans exécuter le programme. Dans des systèmes critiques, des méthodes formelles, comme la méthode B, permettent de démontrer des propriétés précises sous des hypothèses définies, sans garantir à elles seules l’absence de toute défaillance.
Enfin, une mise à jour doit pouvoir être surveillée et, si nécessaire, annulée. Déploiement progressif, sauvegardes vérifiées et procédure de retour arrière réduisent les conséquences d’un défaut passé entre les contrôles. Le bon objectif est double : diminuer les anomalies et limiter leur impact lorsqu’elles surviennent.