L’IA générative peut-elle coder sans supervision ?
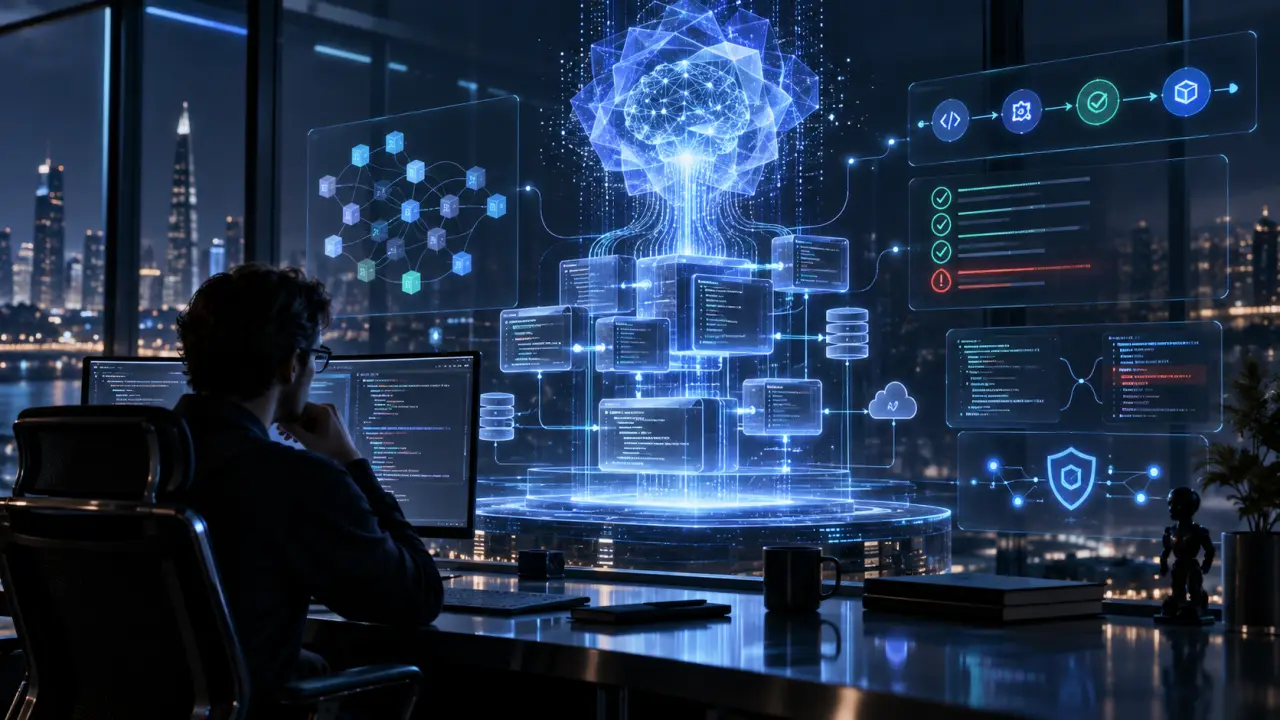
Les modèles génératifs savent désormais produire une fonction, corriger une erreur et proposer l’architecture d’un service complet en quelques secondes. Mais écrire du code n’est pas encore équivalent à concevoir un système fiable. La question n’est donc plus de savoir si l’IA peut programmer, mais jusqu’où elle peut agir seule sans dégrader la qualité, la sécurité ou la responsabilité du projet.
De l’autocomplétion à l’agent logiciel
La première génération d’outils d’assistance se contentait de compléter une ligne ou de transformer une consigne en extrait de code. Les solutions actuelles vont plus loin : elles analysent un dépôt, sélectionnent des fichiers, exécutent des tests et itèrent sur leurs propres modifications. Connectées à un terminal, un gestionnaire de versions et une chaîne d’intégration continue, elles se comportent comme des agents de développement.
Cette évolution change la nature de l’interaction. Le développeur ne demande plus seulement « écris cette fonction », mais « implémente cette fonctionnalité, vérifie les régressions et prépare une proposition de fusion ». L’IA décompose alors l’objectif en tâches intermédiaires. Elle peut être très efficace sur un périmètre bien défini, notamment pour du code répétitif, des tests unitaires ou la migration d’une API.
Ce que l’IA sait réellement faire seule
Dans un environnement balisé, un agent peut déjà prendre en charge une partie substantielle du cycle de développement. Il excelle lorsque les règles sont explicites et que le résultat est facilement vérifiable par des outils automatisés.
- générer des composants, des scripts et des requêtes à partir d’une spécification claire ;
- écrire des tests, repérer des erreurs de typage et proposer des corrections ;
- documenter une base existante ou convertir du code vers une nouvelle bibliothèque ;
- analyser des journaux d’exécution et reproduire certains incidents ;
- ouvrir une demande de fusion accompagnée d’un résumé des changements.
La productivité obtenue est réelle, mais elle dépend d’un principe souvent sous-estimé : l’agent ne travaille pas dans le vide. Il exploite les conventions du dépôt, les tests, les permissions et les instructions qui lui sont fournies. Plus le contexte est propre, plus ses décisions sont prévisibles.
Pourquoi l’autonomie complète reste risquée
Un modèle génératif ne comprend pas un système comme le ferait une équipe qui en porte la responsabilité. Il produit une réponse plausible à partir de régularités apprises et du contexte disponible. Cette nuance devient critique lorsque les exigences sont implicites, contradictoires ou liées à des contraintes métier.
Le premier risque concerne les erreurs silencieuses. Un code qui passe quelques tests peut toujours introduire une fuite de données, une condition de concurrence ou une dégradation progressive des performances. Dans un service exposé, une simple dépendance mal configurée peut devenir une porte d’entrée. Les agents peuvent également reproduire des pratiques obsolètes ou générer des bibliothèques inexistantes, avec une assurance trompeuse.
Le second risque est organisationnel. Qui valide une modification produite sans relecture ? Qui décide qu’un test est suffisant ou qu’une exception de sécurité est acceptable ? L’autonomie technique ne supprime pas la responsabilité humaine : elle peut au contraire la rendre moins visible, surtout lorsque plusieurs agents interviennent sur le même dépôt.
Cette logique de supervision s’applique d’ailleurs au-delà des équipes de développement. Lorsqu’un système numérique sert à suivre des décisions publiques, des projets urbains ou l’activité d’un territoire, la traçabilité des sources et la validation éditoriale restent indispensables. À Angers, Angers Actualité illustre cette nécessité de contextualiser les informations plutôt que de laisser un automatisme agréger des faits sans discernement. Dans les deux cas, la technologie accélère la production, mais le jugement humain donne du sens aux résultats.
Le modèle le plus crédible : une autonomie sous contraintes
La voie la plus robuste n’est ni le refus de l’IA ni le « pilote automatique » intégral. C’est une autonomie graduée, où l’agent dispose de droits proportionnels au risque de sa mission. Une correction de documentation peut être automatisée de bout en bout ; une modification du système d’authentification doit rester soumise à plusieurs validations.
Construire une boucle de contrôle
Avant d’autoriser un agent à modifier le code, il faut définir un bac à sable, limiter ses accès et journaliser toutes ses actions. Les tests unitaires ne suffisent pas : il faut combiner analyse statique, scans de dépendances, tests d’intégration, vérifications de sécurité et revue humaine. Chaque changement doit être réversible et associé à un diff lisible.
Les instructions permanentes du dépôt jouent aussi un rôle central. Elles doivent préciser les versions supportées, les conventions, les interdictions et les critères de validation. Un agent auquel on demande explicitement de ne jamais contourner une vérification, de ne pas manipuler de secrets et de signaler ses incertitudes est plus contrôlable qu’un assistant recevant uniquement une consigne générale.
Mesurer la qualité, pas seulement la vitesse
Le nombre de lignes générées ou de tickets clôturés est un indicateur pauvre. Une équipe doit suivre le taux de réouverture des anomalies, les vulnérabilités détectées après livraison, la complexité ajoutée et la stabilité des déploiements. Ces métriques permettent de vérifier que les gains de vitesse ne sont pas achetés au prix d’une dette technique accrue.
Vers le développeur-orchestrateur
À l’horizon 2026, le rôle du développeur évolue davantage qu’il ne disparaît. Il consiste moins à taper chaque instruction qu’à formuler des objectifs précis, découper un problème, évaluer des compromis et vérifier les hypothèses. La maîtrise des fondamentaux reste essentielle : comprendre la mémoire, les réseaux, les bases de données ou la sécurité permet de repérer une réponse séduisante mais incorrecte.
Dans ce scénario, l’IA générative peut coder sans supervision permanente, mais pas sans supervision conçue à l’avance. Elle devient une force d’exécution rapide dans une architecture de garde-fous. Pour suivre les autres mutations du logiciel, de la cybersécurité et des interfaces immersives, découvrez aussi les analyses publiées sur notre page d’accueil.
La réponse à la question initiale est donc nuancée : oui, une IA peut réaliser seule des tâches de programmation bornées et testables. Non, elle ne peut pas encore porter seule la compréhension du besoin, l’évaluation du risque et la responsabilité d’un système en production. L’avenir appartient aux équipes capables de combiner agents autonomes, contrôles techniques et jugement professionnel.