Intelligence artificielle · Analyse
IA générative : pourquoi l’autonomie reste un mythe
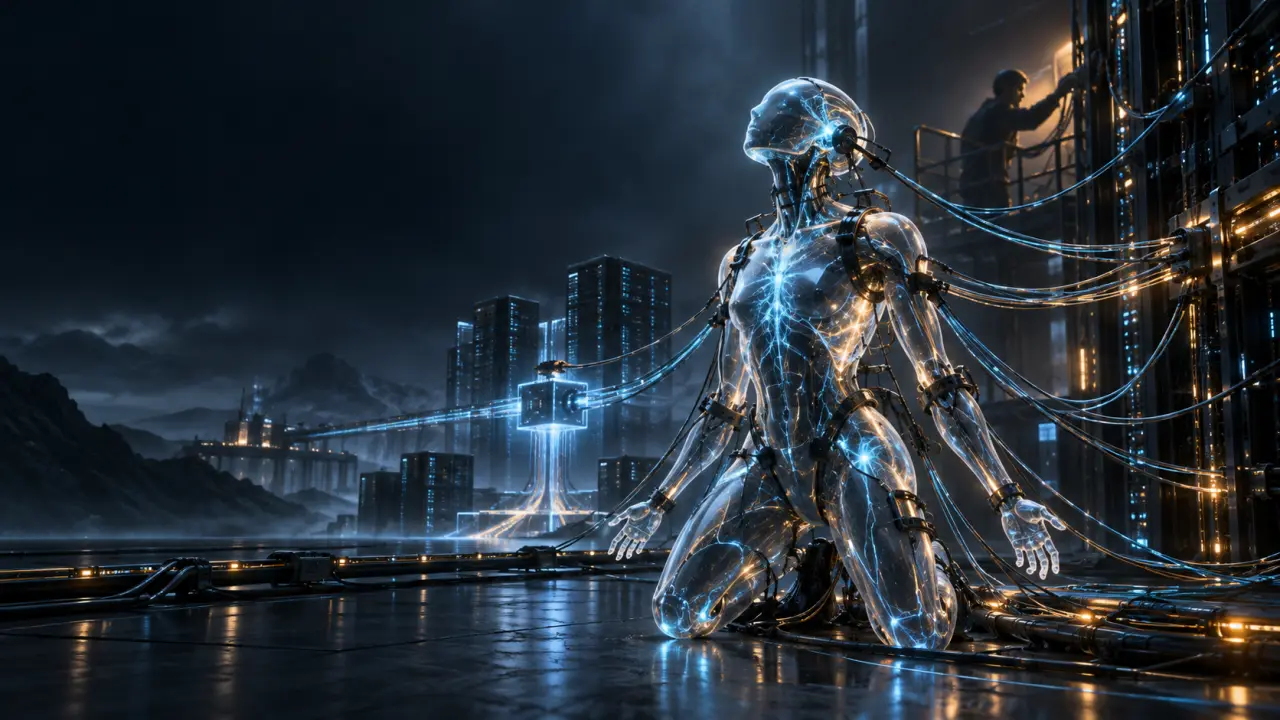
Les modèles génératifs savent écrire du code, produire des images, résumer des documents et enchaîner plusieurs actions. Cette polyvalence nourrit une promesse : celle d’agents capables de travailler seuls. Pourtant, derrière l’apparente fluidité de leurs réponses, l’autonomie reste une construction fragile, dépendante d’un cadre humain, technique et économique.
Une machine qui prédit, pas une entité qui décide
Un modèle de langage ne poursuit pas spontanément un objectif. Il calcule une suite probable de tokens à partir d’un contexte, de paramètres appris et d’instructions reçues. Même lorsqu’il semble raisonner, il n’exécute pas une intention comparable à celle d’un opérateur humain : il génère une sortie statistiquement cohérente avec les exemples et les contraintes disponibles.
Cette distinction devient essentielle dès qu’une tâche dépasse la conversation. Pour réserver une ressource, modifier une base de données ou déployer un service, l’IA doit disposer d’outils, d’identifiants, de permissions et d’un orchestrateur. L’agent n’est donc pas isolé : il dépend d’une architecture qui définit ce qu’il peut observer, appeler et modifier.
Le paradoxe de l’agent autonome : plus on lui donne de latitude pour agir, plus on doit multiplier les garde-fous capables de limiter ses erreurs.
Les quatre dépendances invisibles de l’IA générative
1. La qualité du contexte
Une réponse pertinente suppose des données pertinentes. Or les modèles ne connaissent pas automatiquement l’état réel d’un système, la version actuelle d’une API ou les règles propres à une organisation. Il faut leur fournir un contexte via une base documentaire, une recherche augmentée ou des connecteurs métiers. La qualité de l’agent dépend alors de la fraîcheur, de la structure et des droits associés à ces informations.
2. La définition de l’objectif
Une consigne comme « optimise ce service » paraît claire pour un humain, mais reste incomplète pour une machine. Faut-il réduire les coûts, accélérer le temps de réponse, renforcer la sécurité ou préserver la maintenabilité ? Sans critères mesurables, l’IA peut maximiser le mauvais indicateur. L’autonomie apparente masque ainsi une délégation de décision qui n’a jamais été formalisée.
3. L’accès aux outils
Un agent qui ne peut que rédiger est limité, mais relativement inoffensif. Dès qu’il peut envoyer un message, lancer une commande ou modifier un ticket, la question des permissions devient centrale. Le principe du moindre privilège s’applique ici comme en cybersécurité : chaque outil doit être borné, journalisé et révocable. Une architecture Zero Trust est d’ailleurs plus cohérente avec ces usages qu’un accès réseau implicite.
4. La validation humaine
La supervision ne consiste pas à relire chaque phrase produite. Elle doit se concentrer sur les actions irréversibles, les exceptions et les seuils de risque. Dans un pipeline logiciel, cela peut prendre la forme d’une revue de code, d’un environnement isolé ou d’un déploiement progressif. Dans un service client, il s’agira plutôt d’un transfert automatique vers un opérateur dès qu’un cas sort du périmètre prévu.
L’illusion du raisonnement continu
Les agents modernes décomposent une demande en étapes, mémorisent certains résultats et peuvent corriger une action après observation de son effet. Ce fonctionnement donne l’impression d’une pensée persistante. En réalité, chaque boucle reste conditionnée par des règles d’orchestration : nombre maximal d’itérations, budget de tokens, délais, outils autorisés et critères d’arrêt.
Cette mécanique est efficace pour des tâches bornées. Elle devient moins fiable lorsque l’environnement est incomplet ou contradictoire. Une donnée erronée récupérée au premier appel peut contaminer toute la chaîne. L’agent continuera alors à produire des sorties cohérentes autour d’un postulat faux, phénomène que la simple éloquence de la réponse rend difficile à détecter.
La même tension apparaît dans des usages très ordinaires : recommander une tenue, trier des inspirations ou comparer des pièces exige de tenir compte du contexte, du budget et des préférences réelles. La Boutique de Lilie illustre indirectement cette limite : même face à des sélections automatisées, le choix final dépend encore du goût, du confort et de l’attention humaine portée aux détails.
Vers une autonomie sous contrôle
Il serait pourtant réducteur de conclure que les agents ne sont qu’un effet marketing. Leur valeur est réelle lorsqu’ils prennent en charge des opérations répétitives, vérifiables et réversibles. L’enjeu n’est pas de supprimer l’humain, mais de placer son intervention au bon endroit dans la chaîne de décision.
Pour évaluer sérieusement un système génératif, les équipes IT devraient examiner plusieurs indicateurs :
- le taux d’actions correctement exécutées, et pas seulement la qualité rédactionnelle ;
- la capacité à signaler une incertitude plutôt qu’à inventer une réponse ;
- la traçabilité des sources, des outils appelés et des décisions prises ;
- la facilité d’annulation, de confinement et de reprise manuelle ;
- le coût total, incluant supervision, sécurité, stockage et maintenance.
Le véritable futur : des systèmes supervisés
En 2026, la question pertinente n’est donc plus « quand l’IA deviendra-t-elle autonome ? », mais « quelles responsabilités pouvons-nous lui déléguer sans perdre la maîtrise du système ? ». Cette formulation replace la discussion sur le terrain de l’ingénierie : contrats d’interface, observabilité, gestion des identités, tests adversariaux et gouvernance des données.
L’IA générative restera un composant puissant, mais pas un collègue indépendant doté d’un jugement général. Son autonomie sera toujours relative à un environnement conçu par des humains. Ceux qui construiront des limites explicites, des mécanismes d’arrêt et des boucles de validation obtiendront probablement de meilleurs résultats que ceux qui chercheront à effacer toute friction.
Pour suivre ces mutations, les analyses de Galibyte et de sa rédaction tech décryptent les effets concrets de l’IA, du développement logiciel et de la cybersécurité sur les pratiques professionnelles.